Ingénierie de prompt
1. Introduction
Pendant cette séance, nous allons utiliser LangChain, un cadre pour le développement d’applications qui interagit avec les grands modèles de langage.
Bien que LangChain soit principalement disponible dans les versions Python et TypeScript, il est possible de l’utiliser en Java, grâce à LangChain4j.
Bien que LangChain puisse s’intégrer à différents modèles, ici nous allons nous intéresser à Gemini, de la société Google.
Cet tutoriel est une adaptation d’autres tutoriels sur LangChain4j, disponibles sur Baeldung et sur le site de LongChain4j.
2. Préparation
Pour réaliser ce tutorial, vous aurez besoin d’un compte Google et d’une clé pour l’API de Gemini.
3. Contexte
Avant d’approfondir nos connaissances sur LangChain4j, nous devons comprendre ce que sont les modèles de langage. Nous aborderons également certaines des complexités typiques rencontrées lorsque l’on travaille avec des modèles de langage.
3.1. Grands modèles de langage
Un modèle de langage est un modèle probabiliste d’une langue naturelle qui peut générer des probabilités pour une suite de mots. Un grand modèle de langage (LLM) est un modèle de langage caractérisé par sa grande taille. Il s’agit de réseaux neuronaux artificiels pouvant comporter des milliards de paramètres.
Un LLM est souvent pré-entraîné sur une grande quantité de données non étiquetées à l’aide de techniques d’apprentissage auto-supervisé et semi-supervisé. Ensuite, le modèle pré-entraîné est adapté à des tâches spécifiques à l’aide de diverses techniques telles que le réglage fin et l’ingénierie rapide :
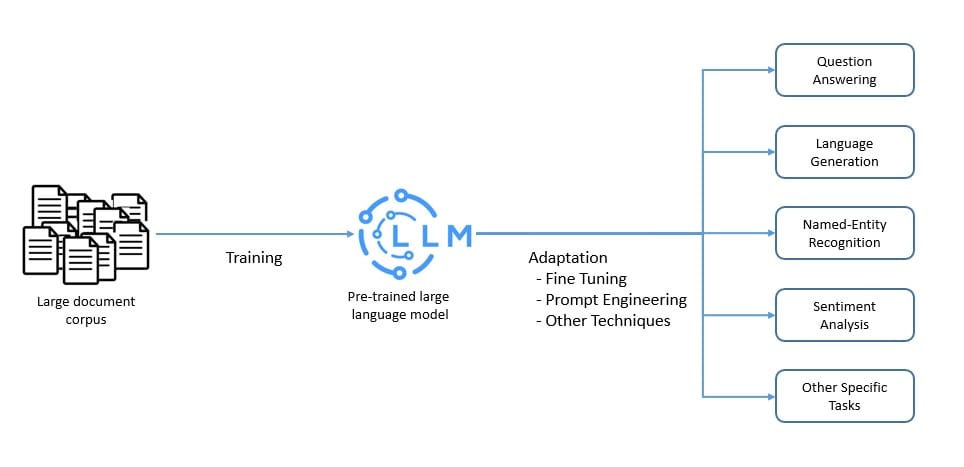
Ces grands modèles sont capables d’effectuer plusieurs tâches de traitement du langage naturel telles que la traduction et le résumé de contenu. Ils sont également capables d’effectuer des tâches génératives telles que la création de contenu. Ils peuvent donc s’avérer extrêmement utiles dans des applications telles que la réponse à des questions.
Presque tous les grands fournisseurs de services en nuage ont inclus de grands modèles de langage dans leurs offres de services. Par exemple, Microsoft Azure propose des LLM tels que Llama 2 et OpenAI GPT-4. Amazon Bedrock propose des modèles d’AI21 Labs, Anthropic, Cohere, Meta et Stability AI.
3.2. Ingénierie de prompt
Les LLM sont des modèles de base formés sur un ensemble massif de données textuelles. Ils peuvent donc capturer la syntaxe et la sémantique inhérentes aux langues humaines. Cependant, ils doivent être adaptés pour effectuer les tâches spécifiques que nous voulons leur confier.
L’ingénierie de prompt est l’un des moyens les plus rapides d’adapter un LLM. Il s’agit d’un processus de structuration du texte qui peut être interprété et compris par un LLM. Ici, nous utilisons un texte en langage naturel pour décrire la tâche que nous attendons d’un LLM :
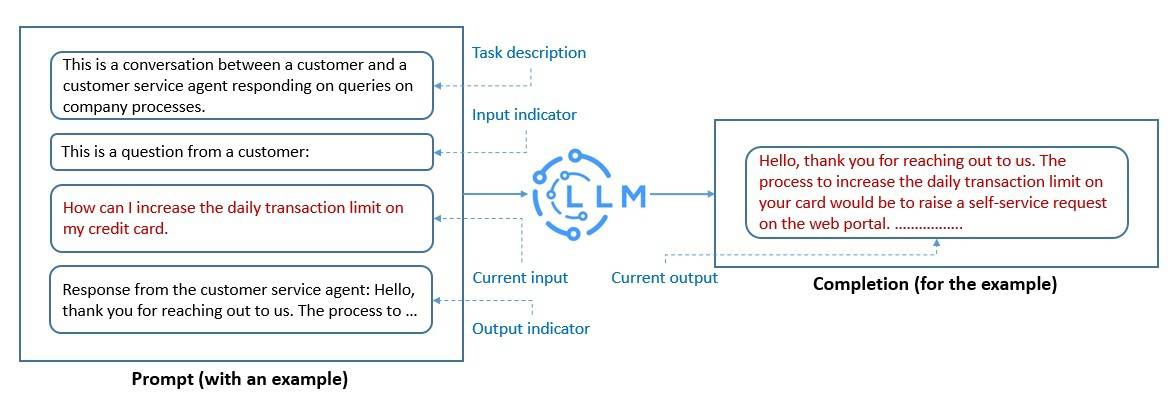
Les prompts que nous créons aident un LLM à effectuer un apprentissage en contexte, ce qui est temporaire. Nous pouvons utiliser l’ingénierie des messages-guides pour promouvoir l’utilisation sûre des LLM et développer de nouvelles capacités telles que l’augmentation des LLM avec la connaissance du domaine et des outils externes.
Il s’agit d’un domaine de recherche actif, et de nouvelles techniques font surface de temps à autre. Cependant, des techniques telles que la réflexion en chaîne sont déjà devenues très populaires. L’idée est de permettre aux LLM de résoudre un problème par une série d’étapes intermédiaires avant de donner une réponse finale.
3.3. Plongement de mots
Comme nous l’avons vu, les LLM sont capables de traiter un grand volume de texte en langue naturelle. Les performances des LLM s’améliorent considérablement si nous représentons les mots dans les langues naturelles comme des plongements de mots. Il s’agit d’un vecteur à valeurs réelles capable d’encoder les significations des mots.
Généralement, les plongements de mots sont générés à l’aide d’un algorithme tel que Word2vec de Tomáš Mikolov ou GloVe de l’université de Stanford. GloVe est un algorithme d’apprentissage non supervisé formé sur les statistiques globales de cooccurrence des mots d’un corpus :
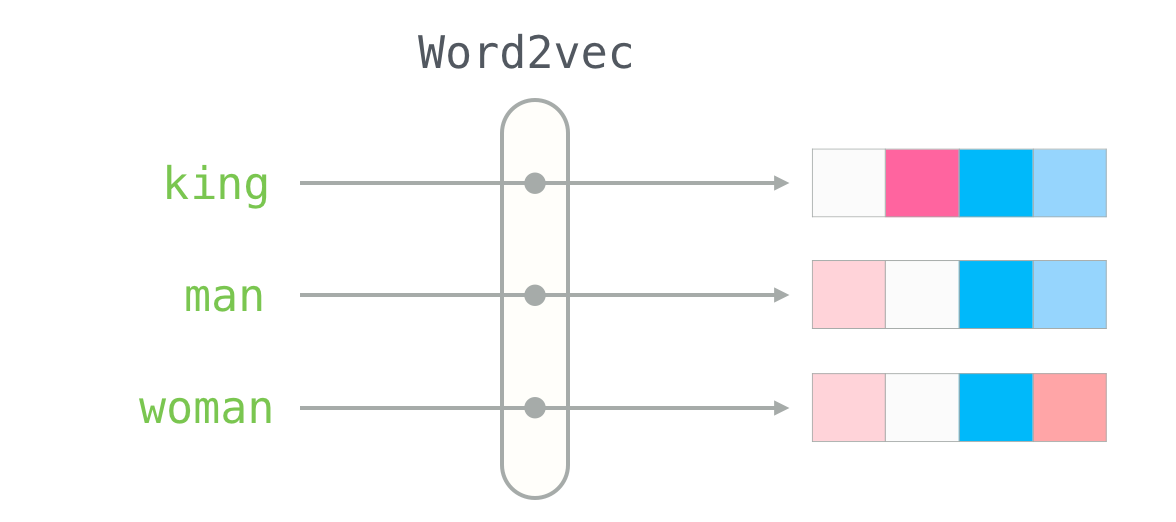
Dans l’ingénierie des messages, nous convertissons les messages en mots intégrés, ce qui permet au modèle de mieux comprendre le message et d’y répondre. En outre, il est également très utile d’augmenter le contexte que nous fournissons au modèle, ce qui lui permet de fournir des réponses plus contextuelles.
Par exemple, nous pouvons générer des enchâssements de mots à partir d’un ensemble de données existant et les stocker dans une base de données vectorielle. En outre, nous pouvons utiliser les données fournies par l’utilisateur pour effectuer une recherche sémantique dans cette base de données vectorielle. Nous pouvons ensuite utiliser le résultat de la recherche comme contexte supplémentaire pour le modèle.
4. La pile technologique de LangChain
La création de prompts efficaces est un élément clé pour exploiter avec succès la puissance des modèles linguistiques dans n’importe quelle application. Il s’agit notamment de rendre l’interaction avec les modèles de langage consciente du contexte et de pouvoir s’appuyer sur un modèle de langage pour raisonner.
Pour ce faire, nous devons effectuer plusieurs tâches, comme créer des modèles pour les prompts, faire des appels aux modèles de langage et fournir aux modèles de langage des données spécifiques à l’utilisateur provenant de sources multiples. Pour simplifier ces tâches, nous avons besoin d’un cadre d’applications comme LangChain dans notre pile technologique LLM :
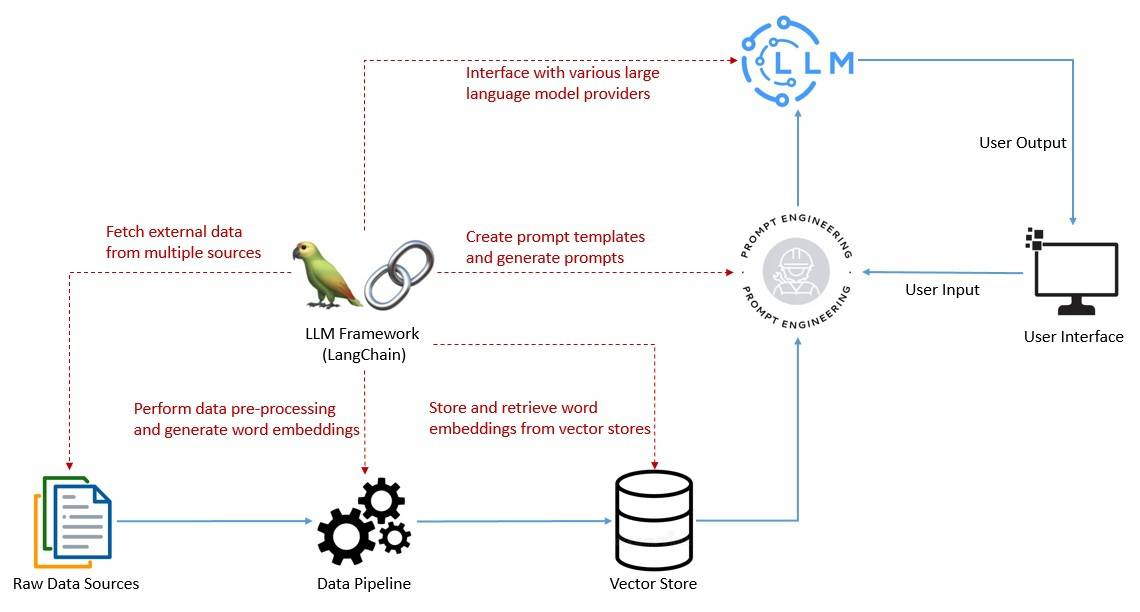
LangChain aide également à développer des applications qui nécessitent l’enchaînement de plusieurs modèles de langage et la possibilité de rappeler des informations sur les interactions passées avec un modèle de langage. Ensuite, il y a des cas d’utilisation plus complexes qui impliquent l’utilisation d’un modèle de langage comme moteur de raisonnement.
Enfin, nous pouvons effectuer la journalisation, la surveillance, la diffusion en continu et d’autres tâches essentielles pour la maintenance et le dépannage. La pile technologique LLM évolue rapidement pour répondre à bon nombre de ces préoccupations. Cependant, LangChain devient rapidement un élément précieux des piles technologiques LLM.
5. LangChain4j
LangChain a été lancé en 2022 en tant que projet open-source et a rapidement pris de l’ampleur grâce au soutien de la communauté. Il a été développé à l’origine en Python, par Harrison Chase.
Une version JavaScript/TypeScript de LangChain a suivi la version Python au début de l’année 2023. Elle est rapidement devenue très populaire et a commencé à prendre en charge de nombreux environnements JavaScript tels que Node et les navigateurs web,.
Il n’existe pas de version officielle de LangChain disponible pour Java. Cependant, il en existe une version communautaire appelée LangChain4j. Elle est disponible pour Java 8 et supporte SpringBoot 2 et 3.
|
Les différents artefacts de LangChain4j sont disponibles sur Maven Central. Vous aurez besoin de choisir les artefacts en fonction du modèle et des fonctionnalités que vous souhaitez utiliser.
Vous aurez aussi besoin de all-MiniLM-L6-v2, un modèle de transformateur de phrases.
Ici, vous aurez besoin de l’artefact de base et de l’implémentation pour Gemini:
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j</artifactId>
    <version>0.35.0</version>
</dependency>

<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-embeddings-all-minilm-l6-v2-q</artifactId>
    <version>0.35.0</version>
</dependency>

<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-google-ai-gemini</artifactId>
    <version>0.35.0</version>
</dependency>
LangChain4j a une conception similaire à LogChain et fournit une couche d’abstractions simple et cohérente, avec des nombreuses implémentations. Il supporte déjà plusieurs modèles de langage comme OpenAI et Llama.
Cependant, comme LangChain évolue rapidement, il est possible certaines fonctionnalités prises en charge dans la version Python ne le soient pas encore dans la version Java. Néanmoins, le concept fondamental, la structure générale et le vocabulaire sont largement identiques.
5.1. Entrée et sortie
Lorsque l’on travaille avec un modèle linguistique, il faut pouvoir s’interfacer avec lui. LangChain fournit les éléments de base nécessaires, comme la possibilité de modéliser les messages-guides et de sélectionner et gérer dynamiquement les entrées du modèle. Il est également possible d’utiliser des analyseurs de sortie pour extraire des informations des sorties du modèle.
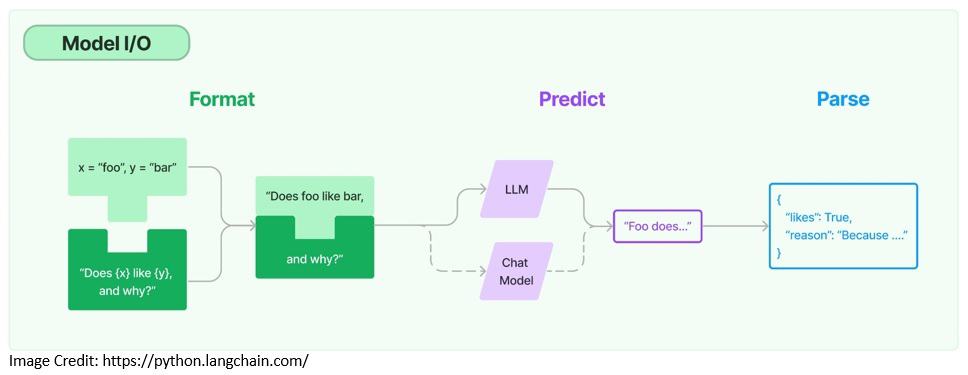
Les prompt templates sont des recettes prédéfinies permettant de générer des invites pour les modèles linguistiques et peuvent inclure des instructions, des exemples courts et un contexte spécifique :
PromptTemplate promptTemplate = PromptTemplate
        .from("Tell me a {{adjective}} joke about {{content}}..");
Map<String, Object> variables = new HashMap<>();
variables.put("adjective", "funny");
variables.put("content", "computers");
Prompt prompt = promptTemplate.apply(variables);
Ici, nous créons un prompt template capable d’accepter plusieurs variables. Les variables sont des éléments que nous recevons (probablement) de l’interface utilisateur et que nous transmettons au prompt.
LangChain permet d’intégrer deux types de modèles, les modèles linguistiques et les modèles de conversation ou de chat. Les modèles de conversation sont également soutenus par des modèles linguistiques, mais ils offrent des fonctionnalités de conversation :
ChatLanguageModel model = GoogleAiGeminiChatModel.builder()
        .apiKey(KEY) // (1)
        .modelName("gemini-2.5-flash-lite")
        .temperature(0.3)
        .build();

String response = model.generate(prompt.text());
System.out.println(response);| 1 | N’oubliez pas de remplacer <KEY> par votre clé d’API. |
| En aucun cas n’envoyez votre clé au le gestionnaire de versions ! |
Ici, nous créons un modèle de chat avec un modèle Gemini particulier,
la clé API associée et une température de 0,3.
Le paramètre température est utilisé pour contrôler le caractère aléatoire de la sortie du modèle.
Enfin, la sortie des modèles de langage peut ne pas être suffisamment structurée pour être présentée. LangChain fournit des analyseurs de sortie qui nous aident à structurer les réponses des modèles de langage. Par exemple, en extrayant les informations de la sortie sous la forme d’un POJO en Java.
|
Si vous avez des problèmes de réseau (timeout), il est possible que votre serveur proxy ne soit pas configuré correctement. Pour tester rapidement, ajoutez les lignes suivantes au début de votre code : |
5.2. Mémoire
En règle générale, une application utilisant un LLM possède une interface conversationnelle. Un aspect important de toute conversation est la possibilité de se référer à des informations introduites plus tôt dans la conversation. La capacité à stocker des informations sur les interactions passées est appelée mémoire :
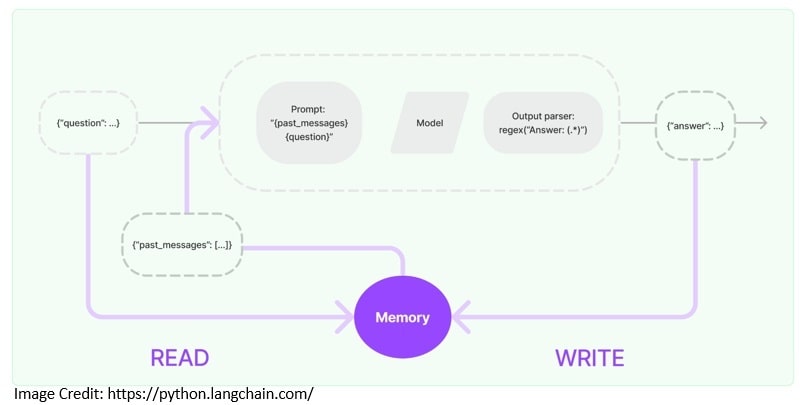
LangChain offre des outils pour ajouter de la mémoire à une interaction. Par exemple, nous avons besoin de la capacité de lire dans la mémoire pour augmenter l’entrée de l’utilisateur. Ensuite, nous devons pouvoir écrire les entrées et les sorties de l’exécution en cours dans la mémoire :
ChatLanguageModel model = GoogleAiGeminiChatModel.builder()
        .apiKey(KEY)
        .modelName("gemini-2.5-flash-lite")
        .temperature(0.3)
        .build();
ChatMemory chatMemory = MessageWindowChatMemory.withMaxMessages(100);
chatMemory.add(UserMessage.userMessage("Hello, my name is Luka."));
AiMessage answer = model.generate(chatMemory.messages()).content();
System.out.println(answer.text());
chatMemory.add(answer);

chatMemory.add(UserMessage.userMessage("What is my name?"));
AiMessage answerWithName = model.generate(chatMemory.messages()).content();
System.out.println(answerWithName.text());
Ici, nous mettons en œuvre une mémoire de chat à fenêtre fixe avec MessageWindowChatMemory,
qui nous permet de lire et d’écrire les messages de chat que nous échangeons avec le modèle linguistique.
LangChain propose également des structures de données et des algorithmes plus complexes pour renvoyer des messages sélectionnés de la mémoire au lieu de tout renvoyer. Par exemple, il est possible de renvoyer un résumé des derniers messages ou de ne renvoyer que les messages pertinents pour l’exécution en cours.
5.3. Génération augmentée de recherche (RAG).
Les grands modèles de langage sont généralement formés sur une grande quantité de corpus de textes. Ils sont donc très efficaces pour les tâches générales, mais peuvent s’avérer moins utiles pour les tâches spécifiques à un domaine. Pour cela, nous devons récupérer des données externes pertinentes et les transmettre au modèle de langage au cours de l’étape de génération.
Ce processus est connu sous le nom de Retrieval Augmented Generation (RAG). Il permet de fonder les modèles sur des informations pertinentes et précises et nous donne un aperçu du processus de génération du modèle. LangChain fournit les éléments nécessaires à la création d’applications RAG :
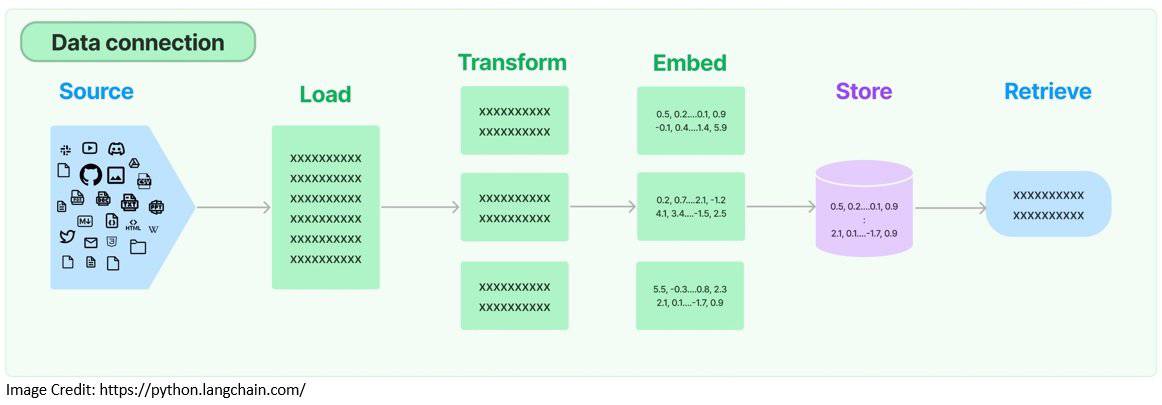
Pour commencer, LangChain fournit des chargeurs de documents qui sont utilisés pour récupérer un document à partir d’un emplacement de stockage. Ensuite, des transformateurs sont disponibles pour préparer les documents en vue d’un traitement ultérieur. Par exemple, nous pouvons demander à LangChain de diviser un document volumineux en plus petits morceaux :
Document document = FileSystemDocumentLoader.loadDocument(Paths.get("src/main/resources/simpson's_adventures.txt")); (1)
DocumentSplitter splitter = DocumentSplitters.recursive(100, 0);
List<TextSegment> segments = splitter.split(document);| 1 | Vous trouverez ce fichier texte sur GitHub. |
Ici, nous utilisons le FileSystemDocumentLoader pour charger un document à partir du système de fichiers.
Ensuite, nous divisons ce document en morceaux plus petits à l’aide de DocumentSplitters.
Pour rendre l’extraction plus efficace, les documents sont généralement convertis dans leurs encastrements et stockés dans des bases de données vectorielles. LangChain prend en charge plusieurs fournisseurs et méthodes d’intégration et s’intègre à la quasi-totalité des bases de données vectorielles courantes :
EmbeddingModel embeddingModel = GoogleAiEmbeddingModel.builder()
        .modelName("gemini-embedding-001")
        .apiKey(KEY)
        .build();
List<Embedding> embeddings = embeddingModel.embedAll(segments)
        .content();
EmbeddingStore<TextSegment> embeddingStore = new InMemoryEmbeddingStore<>();
embeddingStore.addAll(embeddings, segments);
Ici, nous utilisons le modèle GoogleAiEmbeddingModel pour créer les embeddings des segments de documents.
Ensuite, nous stockons les embeddings dans un magasin de vecteurs en mémoire.
Maintenant que nos données externes sont présentes dans un magasin de vecteurs sous forme d’embeddings, nous sommes prêts à les récupérer. LangChain prend en charge plusieurs algorithmes d’extraction comme la recherche sémantique simple et des algorithmes complexes comme l’extraction d’ensemble :
String question = "Who is Simpson?";
Embedding questionEmbedding = embeddingModel.embed(question)
        .content();
int maxResults = 3;
double minScore = 0.7;
List<EmbeddingMatch<TextSegment>> relevantEmbeddings = embeddingStore.findRelevant(questionEmbedding, maxResults,minScore);
Nous avons créé l’intégration de la question de l’utilisateur et utilisons ensuite l’intégration de la question pour récupérer les correspondances pertinentes dans le magasin de vecteurs. Nous pouvons maintenant envoyer les correspondances pertinentes récupérées en tant que contexte en les ajoutant à l’invite que nous avons l’intention d’envoyer au modèle.
6. Applications complexes de LangChain
6.1. Agents
LangChain propose également des fonctionnalités plus avancées, comme les agents. Contrairement aux chaînes, les agents utilisent un modèle linguistique comme moteur de raisonnement pour déterminer les actions à entreprendre et leur ordre. Nous pouvons également fournir aux agents l’accès aux bons outils pour effectuer les actions nécessaires.
Dans LangChain4j, les agents sont disponibles en tant que services d’IA pour définir de manière déclarative un comportement d’IA complexe. Voyons si nous pouvons fournir une calculatrice comme outil pour un service d’IA et permettre à un modèle de langage d’effectuer des calculs.
Tout d’abord, nous allons définir une classe avec quelques fonctions de base de la calculatrice et décrire chaque fonction en langage naturel pour que le modèle puisse la comprendre :
public class ServiceWithTools {
    static class Calculator {
        @Tool("Calculates the length of a string")
        int stringLength(String s) {
            return s.length();
        }

        @Tool("Calculates the sum of two numbers")
        int add(int a, int b) {
            return a + b;
        }
    }
    // ()...)
}
Ensuite, nous allons définir l’interface à partir de laquelle notre service d’IA sera construit. C’est assez simple ici, mais cela peut aussi décrire des comportements plus complexes :
interface Assistant {
    String chat(String userMessage);
}
Vous pouvez déclarer l’interface Assistant à l’intérieur de la classe ServiceWithTools.
|
Nous allons maintenant construire un service d’IA à partir de l’usine de construction fournie par LangChain4j en utilisant l’interface que nous venons de définir et l’outil que nous avons créé et commencer à envoyer à notre modèle linguistique des questions contenant des calculs à effectuer :
public class ServiceWithTools {
    // (...)
    public void run() {
        Assistant assistant = AiServices.builder(Assistant.class)
                .chatLanguageModel(GoogleAiGeminiChatModel.builder()
                        .apiKey(Keys.GEMINI)
                        .modelName("gemini-2.5-flash-lite")
                        .build())
                .tools(new Calculator())
                .chatMemory(MessageWindowChatMemory.withMaxMessages(10))
                .build();

        String question = "What is the sum of the numbers of letters in the words \"language\" and \"model\"?";
        String answer = assistant.chat(question);

        System.out.println(answer);
    }

    public static void main(String[] args) {
        new ServiceWithTools().run();
    }
}
Lorsque ce code est exécuté, nous constatons que le modèle de langage est désormais capable d’effectuer des calculs.
Il est important de noter que les modèles de langage ont des difficultés à effectuer certaines tâches qui nécessitent d’avoir la notion de temps et d’espace ou d’effectuer des procédures arithmétiques complexes. Cependant, il est toujours possible de compléter le modèle avec les outils nécessaires pour résoudre ce problème.